
Google Cloud назвал причину сбоя в us-central1: техник за 13 минут отключил все оптоволоконные кабели
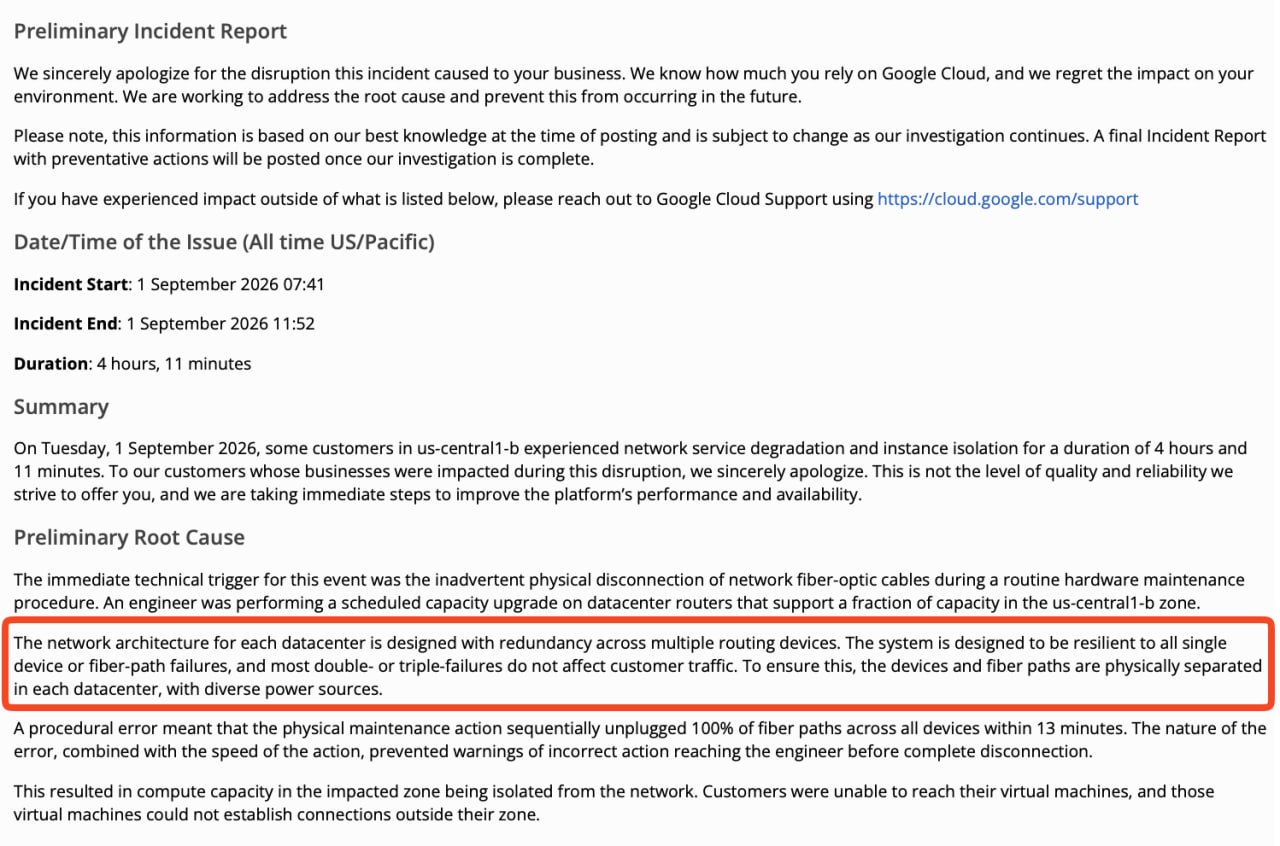
Google Cloud опубликовал предварительный отчёт о крупном сбое в зонах us-central1-b и us-central1-f, который произошёл 1 сентября и длился 4 часа 11 минут. Согласно документу, причиной стала процедурная ошибка во время планового расширения ёмкости маршрутизаторов. Техник выполнял замену оптических трансиверов на более плотные, но новые модули оказались несовместимы с оборудованием в дата-центре.
Работы должны были проводиться по одному маршрутизатору за раз, с перенаправлением трафика и проверкой после каждого шага. Однако в руководстве по обслуживанию не было инструкции о последовательности действий, а также отсутствовали предусмотренные проверки. В результате техник за 13 минут отключил все оптоволоконные соединения на всех устройствах, что привело к изоляции затронутых мощностей от сети.
На пике инцидента падение трафика достигло 100%, виртуальные машины стали недоступны извне и не могли устанавливать исходящие соединения. Затронутыми оказались многие сервисы Google Cloud: Compute Engine, Kubernetes Engine, Cloud Run, App Engine, BigQuery, Cloud SQL, Spanner и другие. Отчёт отмечает, что региональные продукты пострадали меньше благодаря автоматическому переносу трафика.
Сбой был обнаружен практически сразу системами мониторинга, и инженеры начали отводить трафик от повреждённой инфраструктуры. Физическое восстановление соединений началось после того, как специалисты на месте вставили оригинальные трансиверы обратно. К 11:52 по тихоокеанскому времени работоспособность всех сервисов была полностью восстановлена.
Google принёс извинения клиентам и перечислил меры по предотвращению подобных инцидентов. Среди них — обязательная проверка наличия света на каждом отключённом волокне, перевод процессов обновления на полностью автоматическую оркестрацию и внедрение системы экстренной остановки работ при случайном отключении активных кабелей. Также планируется ускорить автоматическое отведение трафика от неисправных зон с 19 до 5 минут.
По данным отчёта, инцидент затронул только часть зон us-central1-b и us-central1-f, причём мультизональные развёртывания с резервированием в других зонах региона в основном продолжали работать.
Первоисточник: status.cloud.google.com ↗