
DeepSeek представила V4.1-Flash для работы с длинным контекстом
DeepSeek выпустила мультимодальную модель класса Mixture-of-Experts (MoE) DeepSeek-V4.1-Flash с 552 млрд параметров и поддержкой контекста до одного миллиона токенов. Модель обрабатывает изображения и текст, генерируя ответы авторегрессионно. Веса доступны на Hugging Face под лицензией MIT.
Архитектура Causal Encoder-Decoder (CED) представляет собой 40-слойный трансформер: 20 слоёв каузального энкодера и 20 слоёв декодера. Во время обработки входных данных активируются 8 млрд параметров на токен, при генерации — 16 млрд. Это снижает вычислительные затраты для задач с длинным контекстом.
Глобальный кэш ключей и значений сокращён до 890 байт на токен — примерно в четыре раза меньше, чем у DeepSeek-V4-Flash. Используются сжатое разреженное внимание CSA2, кэширование в формате FP4 и метод SWA Bounded Replay. В модели также задействованы Engram-память на 196 млрд параметров и спекулятивное декодирование DSpark.
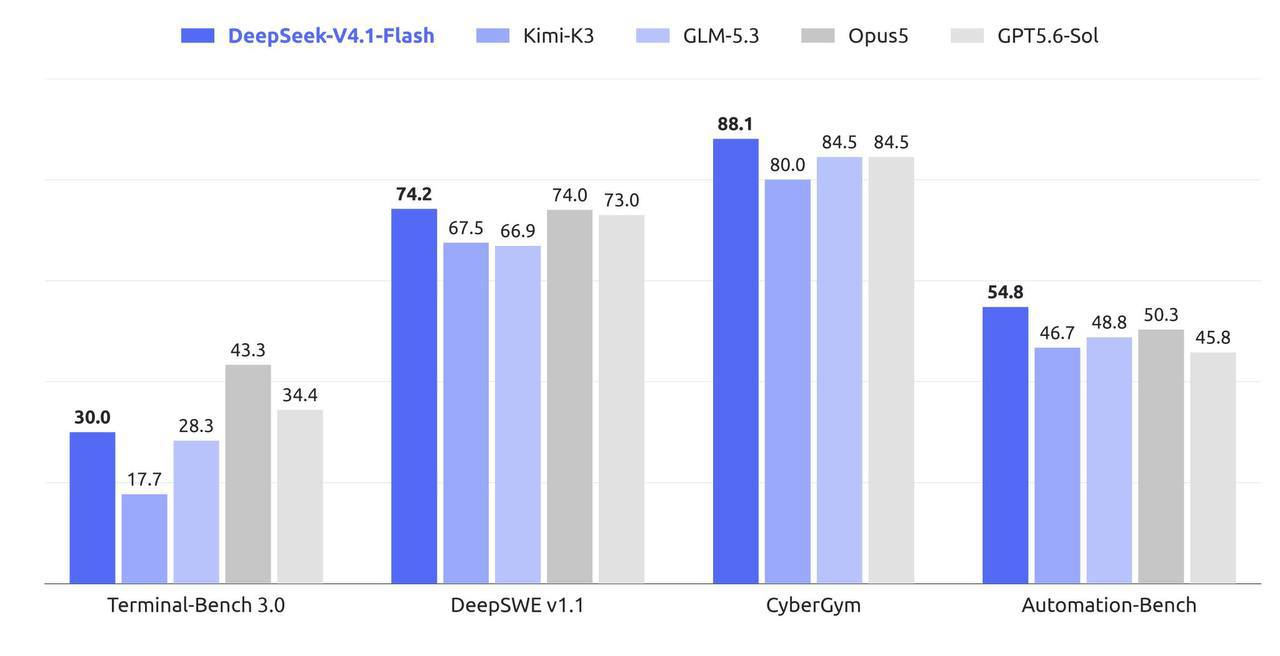
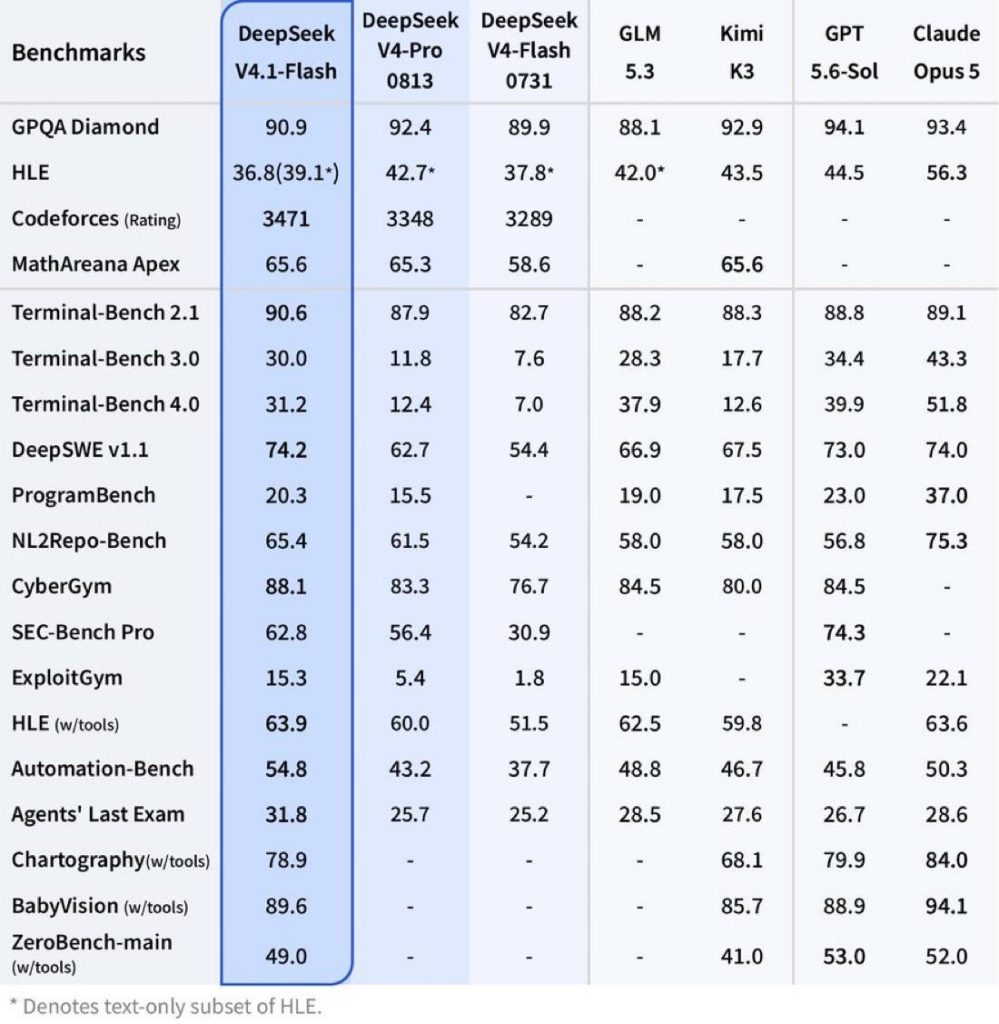
По оценкам DeepSeek, на бенчмарке DeepSWE v1.1 модель набирает 74,2 балла, немного опережая Opus-5.0 (74,0) и GPT-5.6 Sol (73,0). В тесте CyberGym результат — 88,1 против 84,5 у GPT-5.6 Sol. На Terminal-Bench 2.1 модель показала 90,6 балла. Эти цифры приведены для максимального уровня рассуждений (reasoning_effort=100).
В некоторых бенчмарках, например Terminal-Bench 4.0 или ProgramBench, новинка уступает Opus-5.0. Результаты могут варьироваться в зависимости от агентского каркаса: для DeepSWE v1.1 указаны значения от 65,5 до 74,2 в разных средах.
Модель поддерживает непрерывно настраиваемое усилие рассуждения от 1 до 100, что позволяет балансировать точность и вычислительные затраты. Выпущена библиотека deepseek-recipe и референсная реализация кодирования промптов; есть руководства по локальному запуску через vLLM, SGLang и Transformers. За последний месяц модель скачали более 288 тысяч раз.
Снижение активируемых параметров и сжатие кэша могут удешевить развёртывание моделей для длинного контекста, однако независимые проверки заявленных показателей ещё предстоят.
Первоисточник: huggingface.co ↗