
Qwen открыла исходный код Qwen-Image-2.1: генерация и редактирование в одной модели
Редакция XORit · Источники, использование AI и исправления
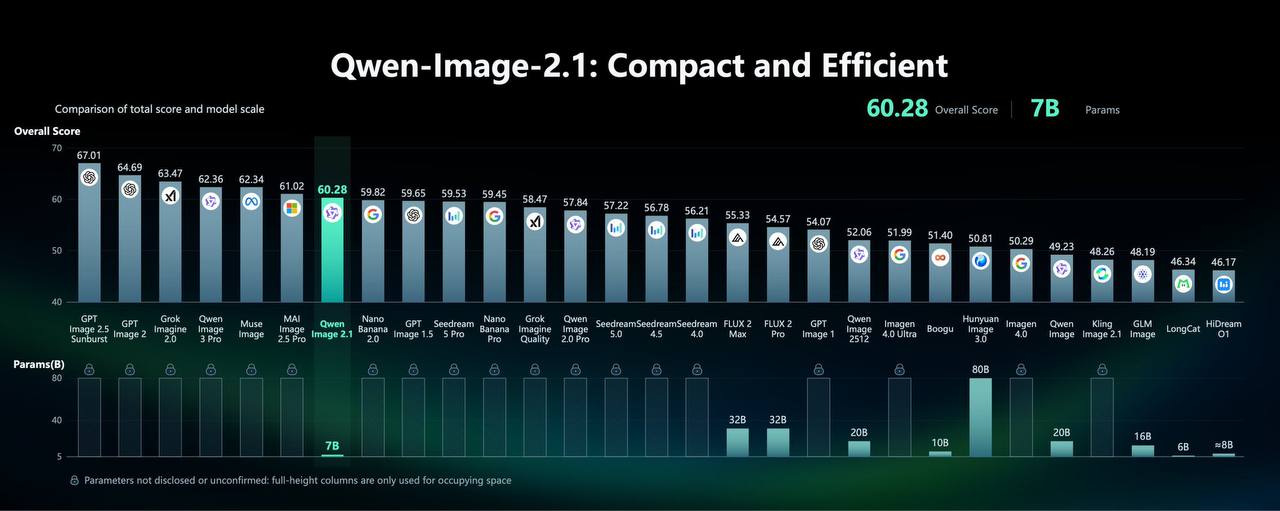
Qwen 20 сентября открыла исходный код Qwen-Image-2.1 — модели, которая в одном наборе весов умеет и генерировать изображения по текстовому описанию, и редактировать их. Визуальная часть весит около 7 млрд параметров, так что ставка сделана на низкие вычислительные затраты, а не на погоню за рекордами.
Технически это одноуровневый DiT из 32 слоёв: текст маскируется по токенам, изображения — блоками. Текстовый энкодер Qwen3-VL 8B переводит инструкции и картинки-условия в общее представление, а префиксный KV-кэш переиспользует их между шагами денойзинга — это ускоряет редактирование с несколькими референсами.
Из деталей: модель нативно делает изображения с прозрачным фоном (RGBA), принимает до 10 референсов и правит только отмеченные области — обведённые кружком, закрашенные или заданные отдельной маской. Модель рассчитана на 2K (по умолчанию 2048×2048 при 40 шагах денойзинга), заявлены также улучшенная типографика и портретное освещение.
Отдельно выложены две модели-переписывателя промптов на базе Qwen3.5-VL 9B — для генерации и для редактирования.
Веса доступны на HuggingFace и ModelScope. Поддержку с первого дня заявили diffusers через QwenImage21Pipeline, ComfyUI (готовые веса Comfy-Org и примеры воркфлоу), vLLM-Omni с FP8-квантованием и префиксным кэшем, а также SGLang и LightX2V.
Лицензия — Qwen Research License Agreement; среди прочего заявлены запуск на GPU AMD Radeon через ROCm и мультичиповые сборки в рамках FlagOS.
Редактор перевода: Салтанов А.
Источник материала: github.com ↗